1000 самых частых английских слов: правда ли, что это 80% речи
Цифра гуляет по интернету в одном и том же виде: выучите тысячу самых частых английских слов — и поймёте 80% речи. Звучит как чит-код. Тысяча слов — это два месяца по десять минут в день, а дальше вроде бы можно жить.
Цифра почти правдивая. Вывод из неё — нет. Разберём, что именно считали и почему из этого не следует то, что кажется.
Откуда взялись 80%
За цифрой стоит реальное свойство языка: слова в нём распределены крайне неравномерно. Горстка слов встречается постоянно, а огромный хвост — по разу на сотни страниц. Эта закономерность известна как закон Ципфа и работает во всех языках.
Отсюда и результат подсчётов по большим корпусам: первая тысяча самых частых слов действительно покрывает порядка 80–85% всех словоупотреблений в бытовой речи. В письменном и более формальном языке доля ниже, около 70–75%, но порядок тот же.
Ключевое слово здесь — словоупотреблений. Считали не смыслы и не предложения, а сколько раз слово попалось в тексте. Из десяти слов подряд восемь окажутся из первой тысячи. Именно это и измерено.
Почему 80% — это не «понимаю»
80% покрытия означает, что каждое пятое слово вам незнакомо. Не каждое пятое предложение — каждое пятое слово.
Исследования понимания текста дают довольно жёсткий ориентир: чтобы читать без словаря и всё понимать, нужно покрытие около 98%, а минимально рабочий порог — примерно 95%. При 80% текст превращается в набор фрагментов, между которыми вы достраиваете смысл догадками. Иногда угадаете, иногда нет, и проверить себя нечем.
| Покрытие | Сколько нужно слов (порядок) | Как это ощущается |
|---|---|---|
| 80% | ~1 000 | Каждое пятое слово мимо. Улавливаете тему, теряете содержание |
| 90% | ~2 000–3 000 | Одно слово из десяти. Читать можно, но тяжело и медленно |
| 95% | ~4 000–5 000 | Рабочий минимум. Понятно почти всё, словарь нужен изредка |
| 98% | ~8 000–9 000 | Свободное чтение без словаря |
Числа в таблице — порядки, а не точные значения, и вот почему их нельзя воспринимать буквально.
Первая подмена: что вообще считается за слово
В разных исследованиях «слово» означает разное, и разница огромная.
- Словоформа. go, goes, went, going, gone — пять единиц.
- Лемма. Те же пять форм — одна единица, go.
- Семья слов. К лемме добавляются производные: nation, national, nationality, nationalize, international — тоже одна единица.
Оценка «нужно 8000 слов» почти всегда считается в семьях. В словоформах это уже под тридцать тысяч. Когда вы видите красивую цифру без уточнения, что именно считали, эта цифра может отличаться от реальности в три-четыре раза.
Вторая подмена: знать слово ≠ знать его значение здесь
Самые частые слова — самые многозначные, и это не совпадение. Слово попадает в топ частотности как раз потому, что обслуживает десятки разных ситуаций.
Глагол get входит в первую сотню любого частотного списка. Вот он в шести значениях:
I got a new phone — получил, купил
I don't get it — не понимаю
It's getting cold — становится
I'll get the door — открою
He got home late — добрался
I got him to help — уговорил
В частотном списке это одна строка. В голове — шесть разных знаний, и обычно человек уверенно владеет двумя. Формально слово «в первой тысяче и выучено», фактически четыре предложения из шести останутся непонятыми.
Третья подмена: 80% приходится не на содержание
Это самое важное. Слова из первой тысячи — в основном служебные и общие: the, of, and, to, be, have, do, go, make, very. Они держат конструкцию предложения, но не несут его смысла.
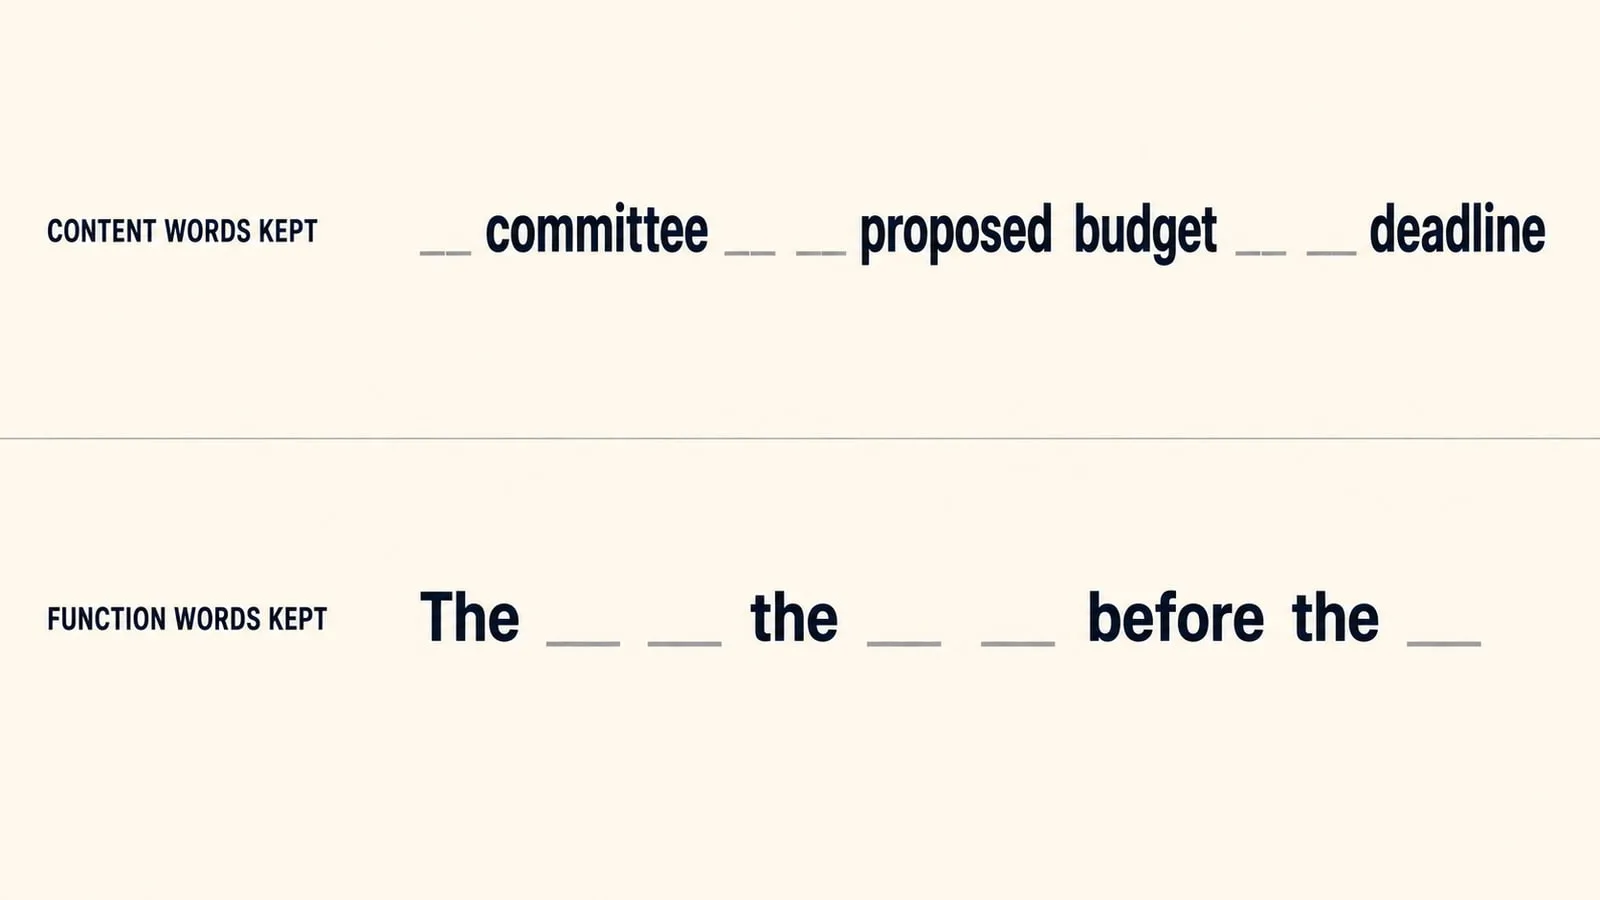
Смысл несут существительные и глаголы, специфичные для темы, — а они лежат как раз в тех самых 20%. Посмотрите на одно и то же предложение с закрытыми разными частями:
Убрали служебные слова:
___ committee ___ ___ proposed budget ___ ___ deadline.
Понятно: комитет, бюджет, срок. Смысл в целом восстанавливается.Убрали содержательные слова:
The ___ ___ the ___ ___ before the ___.
Понятно: ничего.
Вот почему ощущение «я знаю слова, но не понимаю, о чём речь» — не иллюзия и не отсутствие практики. Вы действительно знаете 80% слов и действительно не знаете, о чём предложение.
Так учить первую тысячу или нет
Учить. Просто с правильными ожиданиями.
Первая тысяча окупается лучше всего, что вы вообще можете выучить. Эти слова встречаются в каждом предложении, повторяются сами по себе, и без них не работает ничего: вы не сможете ни читать с контекстом, ни догадываться о новом. Это фундамент, и на него не жалко потратить два месяца.
Вторая тысяча тоже окупается, хотя заметно медленнее: прирост покрытия с 80% до 90% требует вдвое больше слов, чем первые 80%.
А вот дальше общая частотность перестаёт быть правильным критерием. После примерно двух тысяч слова из общего списка начинают попадаться вам всё реже, а вот слова из ваших собственных тем — постоянно. Программисту нужен один набор, врачу другой, человеку, который смотрит криминальные сериалы, третий. Общий частотный список этого не знает.
Дальше эффективнее работает не список, а собственная подборка слов, собранная из того, что вы реально читаете и смотрите. У неё частотность считается по вашей жизни, а не по усреднённому корпусу.
Как это выглядит на практике
- Первая тысяча — списком и целенаправленно. Здесь готовый частотный список идеален: слова всё равно неизбежны, порядок значения почти не имеет.
- Для частых слов учите значения, а не слово. Встретили get в новом смысле — это новая карточка, а не «уже знаю».
- После двух тысяч переключайтесь на захват. Всё, что споткнуло вас в реальном тексте, идёт в личный словарь.
- Считайте не слова, а покрытие. Полезный вопрос не «сколько слов я знаю», а «сколько незнакомых на странице». Про подсчёт словарного запаса есть отдельный разбор с процедурой.
Именно на третьем шаге обычно всё и рассыпается: слова попадаются, но не сохраняются, и через месяц вы встречаете их заново. В VibeLing это устроено так: добавляете слово в момент встречи, приложение достраивает перевод, примеры и произношение, а потом само возвращает его на повторение по интервалам — до того, как оно успеет забыться.
Короткий ответ
Правда ли, что тысяча слов даёт 80% речи? Да, если считать словоупотребления.
Означает ли это, что вы будете понимать 80% сказанного? Нет. Вы будете узнавать 80% слов и понимать заметно меньше, потому что непонятыми окажутся ровно те слова, ради которых предложение произнесли.
Тысяча — это не финиш и не 80% пути. Это стартовая площадка, без которой не работает всё остальное, и её стоит взять как можно быстрее. А дальше растёт уже не список, а ваш личный словарь.