Les 1000 mots anglais les plus fréquents : couvrent-ils vraiment 80 % ?
Le chiffre circule toujours sous la même forme : apprenez les 1000 mots anglais les plus fréquents et vous comprendrez 80 % de ce qui se dit. On dirait un code de triche. Mille mots, c'est deux mois à dix minutes par jour, et après on peut apparemment vivre tranquille.
Le chiffre est presque exact. La conclusion qu'on en tire, non. Voyons ce qui a été mesuré au juste et pourquoi cela n'implique pas ce qu'on croit.
D'où viennent les 80 %
Derrière ce chiffre il y a une propriété réelle de la langue : les mots y sont répartis de façon très inégale. Une poignée revient sans arrêt, et une immense queue apparaît une fois toutes les centaines de pages. Cette régularité s'appelle la loi de Zipf et vaut dans toutes les langues.
D'où le résultat des comptages sur de grands corpus : les mille premiers mots les plus fréquents couvrent effectivement de l'ordre de 80–85 % de toutes les occurrences dans la langue courante. À l'écrit et dans un registre plus formel la part descend, autour de 70–75 %, mais l'ordre de grandeur est le même.
Le mot-clé ici, c'est occurrences. On n'a compté ni des sens ni des phrases, mais le nombre de fois qu'un mot apparaît dans un texte. Sur dix mots d'affilée, huit viendront des mille premiers. C'est cela qui a été mesuré.
Pourquoi 80 % ne veut pas dire « je comprends »
Une couverture de 80 %, cela signifie qu'un mot sur cinq vous est inconnu. Pas une phrase sur cinq : un mot sur cinq.
Les recherches sur la compréhension en lecture donnent un repère assez dur : pour lire sans dictionnaire et tout comprendre, il faut une couverture d'environ 98 %, le seuil minimal utilisable étant vers 95 %. À 80 %, le texte se transforme en fragments entre lesquels vous reconstruisez le sens par supposition. Parfois vous devinez juste, parfois non, et rien ne permet de vérifier.
| Couverture | Mots nécessaires (ordre) | Ce que ça donne |
|---|---|---|
| 80 % | ~1 000 | Un mot sur cinq passe à côté. Vous saisissez le sujet, pas le contenu |
| 90 % | ~2 000–3 000 | Un mot sur dix. Lisible, mais lourd et lent |
| 95 % | ~4 000–5 000 | Le minimum de travail. Presque tout est clair, dictionnaire occasionnel |
| 98 % | ~8 000–9 000 | Lecture confortable sans dictionnaire |
Les nombres du tableau sont des ordres de grandeur, pas des valeurs exactes — et voici pourquoi on ne peut pas les prendre au pied de la lettre.
Premier glissement : ce qui compte comme un mot
Selon les études, « mot » désigne des choses différentes, et l'écart est énorme.
- Forme fléchie. go, goes, went, going, gone — cinq unités.
- Lemme. Ces mêmes cinq formes — une unité, go.
- Famille de mots. Au lemme s'ajoutent les dérivés : nation, national, nationality, nationalize, international — également une unité.
L'estimation « il faut 8000 mots » est presque toujours comptée en familles. En formes fléchies, on approche les trente mille. Quand vous voyez un beau chiffre sans précision sur ce qui a été compté, il peut être à côté d'un facteur trois ou quatre.
Deuxième glissement : connaître un mot ≠ connaître ce sens-là
Les mots les plus fréquents sont les plus polysémiques, et ce n'est pas un hasard. Un mot arrive en tête de fréquence précisément parce qu'il sert dans des dizaines de situations différentes.
Le verbe get figure dans la première centaine de n'importe quelle liste de fréquence. Le voici en six sens :
I got a new phone — j'ai eu, acheté
I don't get it — je ne comprends pas
It's getting cold — ça devient
I'll get the door — j'ouvre
He got home late — il est rentré
I got him to help — je l'ai convaincu
Dans la liste de fréquence, c'est une ligne. Dans la tête, ce sont six connaissances distinctes, et on en maîtrise généralement deux avec assurance. Formellement le mot est « dans les mille premiers et appris » ; dans les faits, quatre phrases sur six restent incomprises.
Troisième glissement : les 80 % ne sont pas là où est le contenu
C'est le point le plus important. Les mots des mille premiers sont surtout grammaticaux et généraux : the, of, and, to, be, have, do, go, make, very. Ils tiennent la construction de la phrase mais ne portent pas son sens.
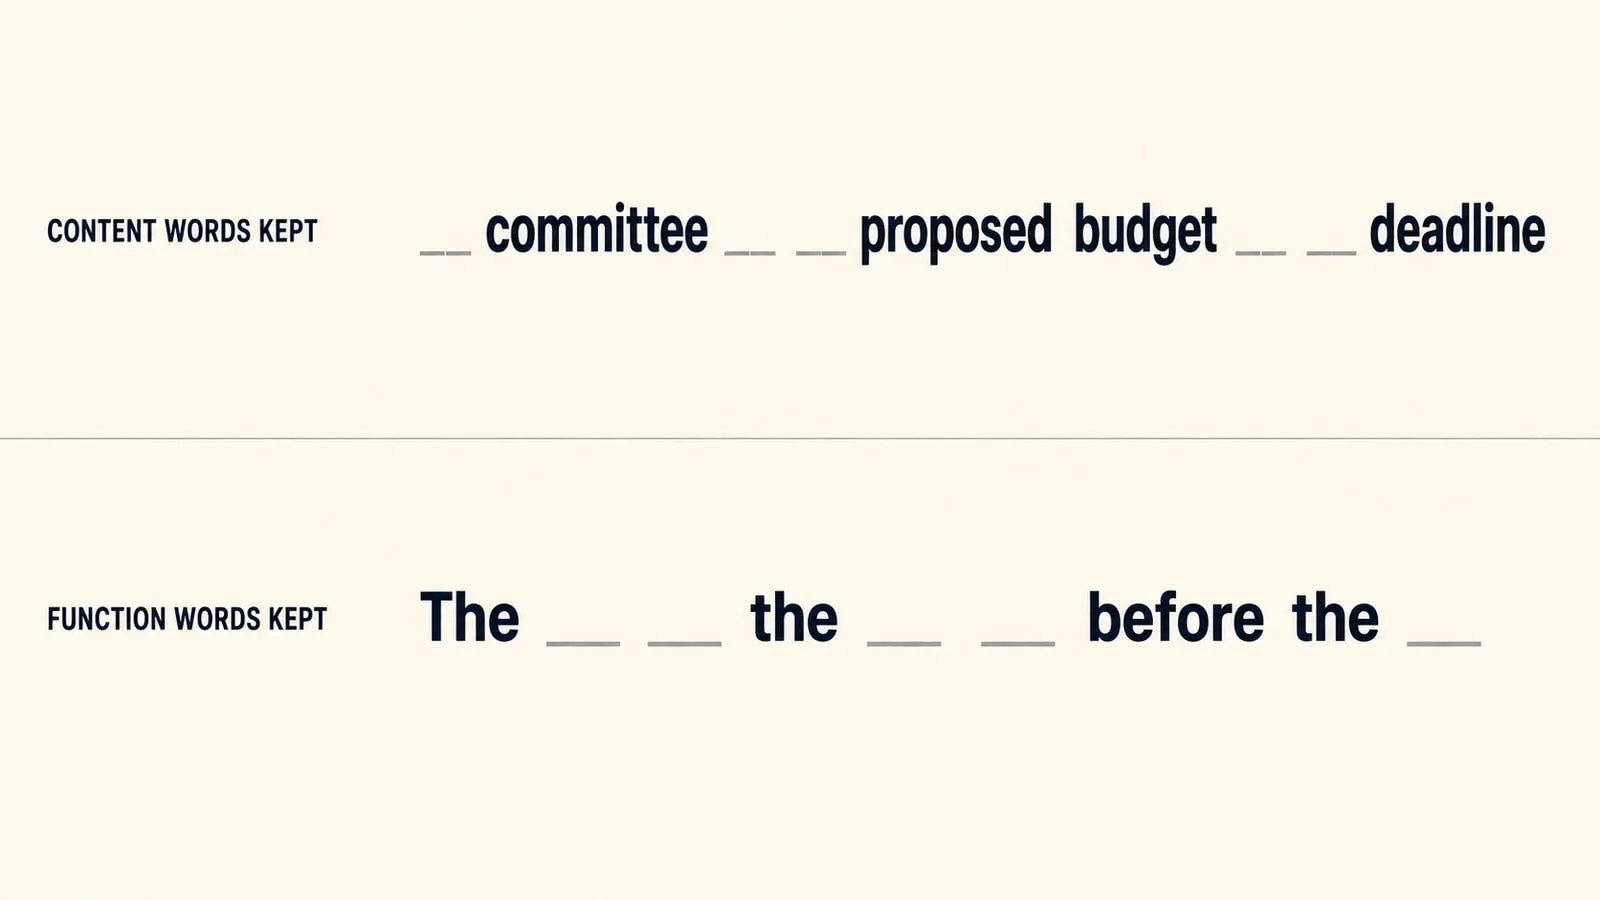
Le sens est porté par les noms et les verbes spécifiques au sujet — et ceux-là sont justement dans les 20 % restants. Regardez la même phrase avec des parties différentes masquées :
Mots grammaticaux retirés :
___ committee ___ ___ proposed budget ___ ___ deadline.
On comprend : comité, budget, échéance. Le sens général se reconstitue.Mots de contenu retirés :
The ___ ___ the ___ ___ before the ___.
On comprend : rien.
Voilà pourquoi la sensation « je connais les mots mais je ne sais pas de quoi ça parle » n'est ni une illusion ni un manque de pratique. Vous connaissez réellement 80 % des mots et vous ignorez réellement de quoi parle la phrase.
Alors, apprendre les mille premiers ou pas ?
Les apprendre. Simplement avec les bonnes attentes.
Les mille premiers rapportent plus que tout ce que vous pourriez apprendre d'autre. Ces mots apparaissent dans chaque phrase, se répètent d'eux-mêmes, et sans eux rien ne fonctionne : impossible de lire avec le contexte ni de deviner du nouveau. C'est la fondation, et deux mois là-dessus ne sont pas perdus.
Les mille suivants rapportent aussi, nettement plus lentement : passer de 80 % à 90 % de couverture demande deux fois plus de mots que les premiers 80 %.
Ensuite, la fréquence générale cesse d'être le bon critère. Passé environ deux mille mots, ceux de la liste générale vous tombent dessus de plus en plus rarement, alors que ceux de vos propres sujets reviennent sans arrêt. Un développeur a besoin d'un ensemble, un médecin d'un autre, quelqu'un qui regarde des séries policières d'un troisième. La liste de fréquence générale n'en sait rien.
Au-delà, ce qui marche mieux qu'une liste, c'est une collection que vous constituez vous-même à partir de ce que vous lisez et regardez vraiment. Là, la fréquence se calcule sur votre vie et non sur un corpus moyen.
À quoi ça ressemble en pratique
- Les mille premiers : par liste et délibérément. Ici une liste de fréquence toute faite est idéale : les mots sont de toute façon inévitables et l'ordre importe peu.
- Pour les mots fréquents, apprenez des sens, pas des mots. get rencontré dans un sens nouveau ? C'est une nouvelle carte, pas un « je connais déjà ».
- Après deux mille, passez à la capture. Tout ce qui vous a fait trébucher dans un texte réel va dans votre dictionnaire personnel.
- Comptez la couverture, pas les mots. La bonne question n'est pas « combien de mots je connais » mais « combien d'inconnus par page ». Sur le comptage du vocabulaire il y a une analyse à part avec une procédure.
C'est à la troisième étape que tout s'effondre d'habitude : les mots apparaissent mais ne sont pas conservés, et un mois plus tard vous les recroisez comme neufs. Dans VibeLing, c'est organisé ainsi : vous ajoutez le mot au moment où vous le croisez, l'application complète la traduction, les exemples et la prononciation, puis vous le ramène en révision par intervalles — avant qu'il ait le temps d'être oublié.
La réponse courte
Est-il vrai que mille mots donnent 80 % de la parole ? Oui, si l'on compte les occurrences.
Cela veut-il dire que vous comprendrez 80 % de ce qui se dit ? Non. Vous reconnaîtrez 80 % des mots et vous comprendrez sensiblement moins, parce que les mots incompris seront exactement ceux pour lesquels la phrase a été prononcée.
Mille, ce n'est ni l'arrivée ni 80 % du chemin. C'est le tremplin sans lequel rien d'autre ne fonctionne, et il vaut mieux le franchir vite. Ensuite, ce qui grandit n'est plus une liste, mais votre dictionnaire personnel.