Las 1000 palabras más frecuentes en inglés: ¿de verdad cubren el 80%?
La cifra circula por internet siempre igual: aprende las mil palabras más frecuentes del inglés y entenderás el 80% del habla. Suena a truco. Mil palabras son dos meses a diez minutos al día, y a partir de ahí parece que ya se puede vivir.
La cifra es casi verdadera. La conclusión que se saca de ella, no. Veamos qué se midió exactamente y por qué de ahí no se sigue lo que parece.
De dónde salió el 80%
Detrás de la cifra hay una propiedad real de la lengua: las palabras se distribuyen de forma muy desigual. Un puñado aparece constantemente y una cola enorme sale una vez cada cientos de páginas. Esta regularidad se conoce como ley de Zipf y funciona en todos los idiomas.
De ahí el resultado de los recuentos sobre grandes corpus: las primeras mil palabras más frecuentes cubren efectivamente en torno al 80–85% de todas las ocurrencias en el habla cotidiana. En la lengua escrita y más formal la proporción baja, alrededor del 70–75%, pero el orden es el mismo.
La palabra clave aquí es ocurrencias. No se contaron significados ni frases, sino cuántas veces apareció una palabra en el texto. De cada diez palabras seguidas, ocho serán de las primeras mil. Eso es lo que se ha medido.
Por qué 80% no es «entiendo»
Una cobertura del 80% significa que cada quinta palabra te resulta desconocida. No cada quinta frase: cada quinta palabra.
Los estudios sobre comprensión lectora dan una referencia bastante dura: para leer sin diccionario y entenderlo todo hace falta una cobertura de alrededor del 98%, con un umbral mínimo operativo cerca del 95%. Con un 80% el texto se convierte en un conjunto de fragmentos entre los que reconstruyes el sentido a base de suposiciones. A veces aciertas, a veces no, y no tienes con qué comprobarlo.
| Cobertura | Palabras necesarias (orden) | Cómo se siente |
|---|---|---|
| 80% | ~1 000 | Cada quinta palabra se escapa. Captas el tema, pierdes el contenido |
| 90% | ~2 000–3 000 | Una palabra de cada diez. Se puede leer, pero cuesta y va lento |
| 95% | ~4 000–5 000 | El mínimo operativo. Se entiende casi todo, el diccionario es ocasional |
| 98% | ~8 000–9 000 | Lectura cómoda sin diccionario |
Las cifras de la tabla son órdenes de magnitud, no valores exactos, y ahora verás por qué no se pueden tomar al pie de la letra.
Primera trampa: qué cuenta como palabra
En distintos estudios «palabra» significa cosas distintas, y la diferencia es enorme.
- Forma. go, goes, went, going, gone: cinco unidades.
- Lema. Esas mismas cinco formas: una unidad, go.
- Familia de palabras. Al lema se le suman los derivados: nation, national, nationality, nationalize, international: también una unidad.
La estimación de «hacen falta 8000 palabras» casi siempre está contada en familias. En formas ya son casi treinta mil. Cuando ves una cifra redonda sin precisar qué se contó, esa cifra puede alejarse de la realidad por un factor de tres o cuatro.
Segunda trampa: saber la palabra no es saber su sentido aquí
Las palabras más frecuentes son las más polisémicas, y no es casualidad. Una palabra entra en el top de frecuencia precisamente porque sirve para decenas de situaciones distintas.
El verbo get está en el primer centenar de cualquier lista de frecuencia. Aquí en seis sentidos:
I got a new phone — conseguí, compré
I don't get it — no entiendo
It's getting cold — se está poniendo
I'll get the door — abro yo
He got home late — llegó
I got him to help — lo convencí
En la lista de frecuencia es una línea. En tu cabeza son seis conocimientos distintos, y normalmente uno domina dos con seguridad. Formalmente la palabra «está en las primeras mil y está aprendida»; de hecho cuatro frases de seis quedan sin entender.
Tercera trampa: el 80% no está en el contenido
Esto es lo más importante. Las palabras de las primeras mil son sobre todo funcionales y generales: the, of, and, to, be, have, do, go, make, very. Sostienen la construcción de la frase, pero no llevan su sentido.
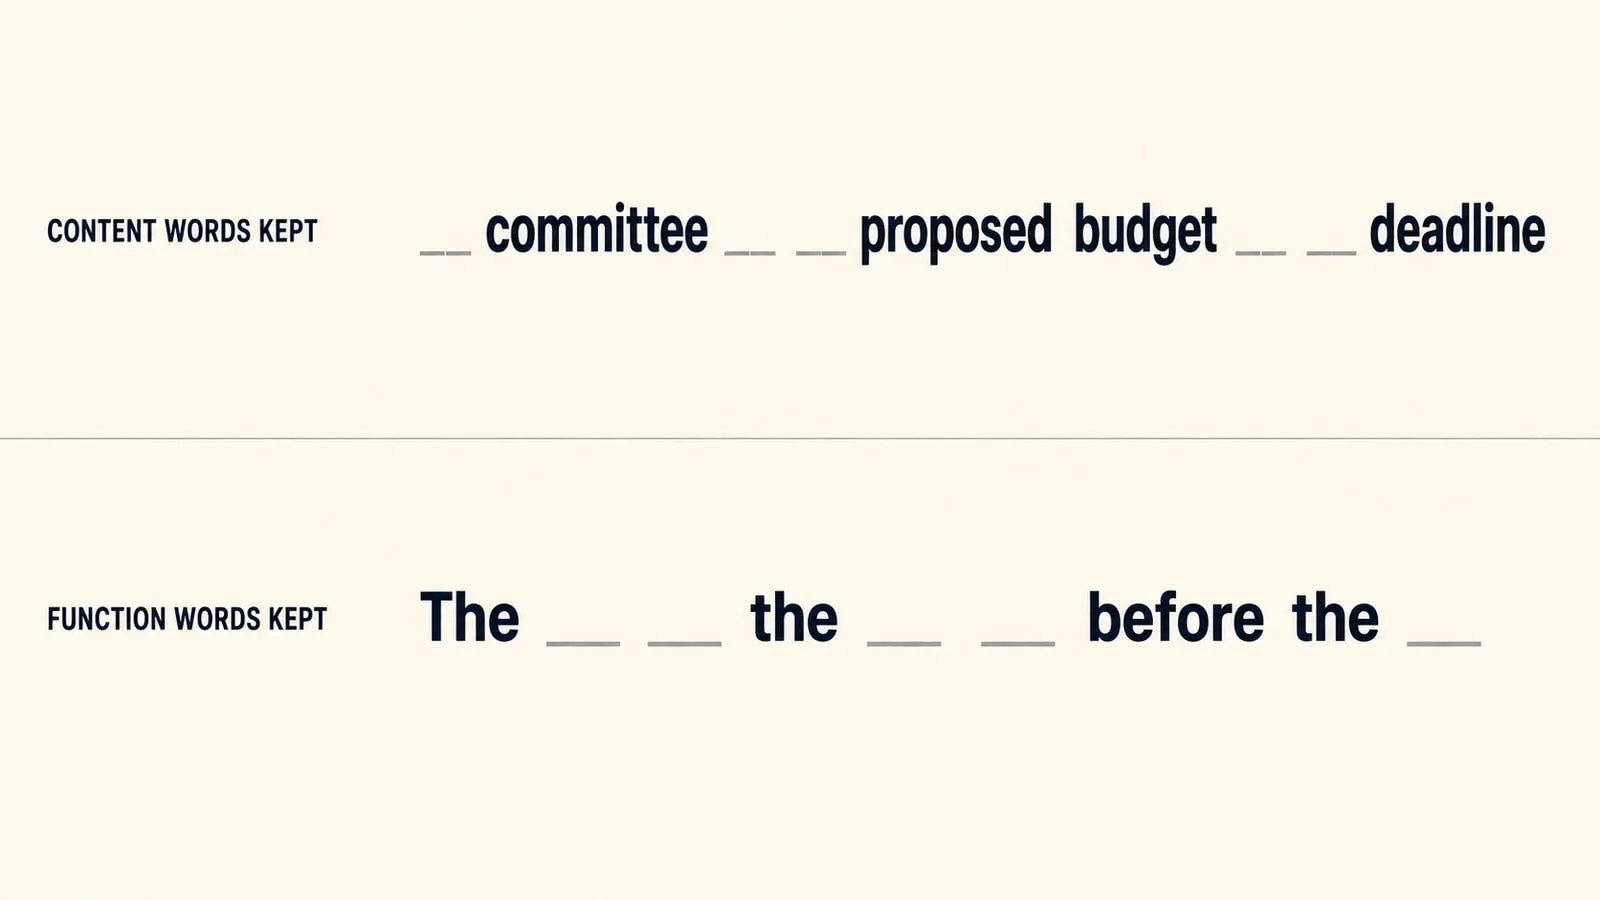
El sentido lo llevan los sustantivos y verbos específicos del tema, y esos están justo en ese 20% restante. Mira la misma frase con partes distintas tapadas:
Quitamos las palabras funcionales:
___ committee ___ ___ proposed budget ___ ___ deadline.
Se entiende: comité, presupuesto, plazo. El sentido general se recompone.Quitamos las palabras de contenido:
The ___ ___ the ___ ___ before the ___.
Se entiende: nada.
Por eso la sensación de «conozco las palabras pero no sé de qué va» no es una ilusión ni falta de práctica. Realmente conoces el 80% de las palabras y realmente no sabes de qué habla la frase.
¿Entonces se aprenden las primeras mil o no?
Sí. Solo que con las expectativas correctas.
Las primeras mil rinden más que cualquier otra cosa que puedas aprender. Aparecen en cada frase, se repiten solas y sin ellas no funciona nada: no podrás leer con contexto ni deducir lo nuevo. Es el cimiento, y no da pena gastar dos meses en él.
Las segundas mil también rinden, aunque bastante más despacio: pasar de un 80% a un 90% de cobertura exige el doble de palabras que el primer 80%.
Pero a partir de ahí la frecuencia general deja de ser el criterio correcto. Después de unas dos mil, las palabras de la lista general empiezan a aparecerte cada vez menos, mientras que las de tus propios temas salen constantemente. Un programador necesita un conjunto, un médico otro, y quien ve series policíacas un tercero. La lista general de frecuencia no sabe nada de eso.
A partir de ahí funciona mejor no una lista, sino una colección propia montada con lo que realmente lees y ves. Ahí la frecuencia se calcula sobre tu vida y no sobre un corpus promedio.
Cómo se ve esto en la práctica
- Las primeras mil: con lista y a propósito. Aquí una lista de frecuencia ya hecha es ideal: las palabras son inevitables y el orden casi da igual.
- De las palabras frecuentes aprende sentidos, no palabras. ¿Te encontraste get con un sentido nuevo? Es una tarjeta nueva, no un «ya la sé».
- Después de las dos mil, cambia a la captura. Todo lo que te haga tropezar en un texto real va a tu diccionario personal.
- Cuenta cobertura, no palabras. La pregunta útil no es «cuántas palabras sé», sino «cuántas desconocidas hay por página». Sobre el recuento del vocabulario hay un análisis aparte con procedimiento.
Es en el tercer paso donde todo suele desmoronarse: las palabras aparecen pero no se guardan, y al mes las vuelves a encontrar como nuevas. En VibeLing está montado así: añades la palabra en el momento en que la encuentras, la app completa la traducción, los ejemplos y la pronunciación, y luego te la devuelve para repasarla por intervalos, antes de que te dé tiempo a olvidarla.
La respuesta corta
¿Es verdad que mil palabras dan el 80% del habla? Sí, si contamos ocurrencias.
¿Significa que entenderás el 80% de lo que se dice? No. Reconocerás el 80% de las palabras y entenderás bastante menos, porque las que se te escapan son exactamente aquellas por las que se pronunció la frase.
Mil no es la meta ni el 80% del camino. Es la plataforma de salida sin la cual no funciona todo lo demás, y conviene alcanzarla cuanto antes. A partir de ahí ya no crece una lista, sino tu diccionario personal.